華為云MapReduce服務 功能優(yōu)勢解析與上云無憂的數(shù)據(jù)處理實踐
在當今數(shù)據(jù)驅動的時代,企業(yè)面臨著海量數(shù)據(jù)處理的嚴峻挑戰(zhàn)。傳統(tǒng)的數(shù)據(jù)處理架構往往在擴展性、成本和運維復雜度上捉襟見肘。華為云MapReduce服務(MRS)應運而生,作為一款全托管的企業(yè)級大數(shù)據(jù)處理平臺,它旨在為企業(yè)提供一站式、高性能、安全可靠的大數(shù)據(jù)解決方案,真正實現(xiàn)“上云無憂,數(shù)據(jù)處理服務”。
一、服務簡介:企業(yè)級大數(shù)據(jù)處理的云上基石
華為云MapReduce服務是一個基于開源生態(tài)(如Apache Hadoop、Spark、Flink、HBase、Kafka等)構建的云原生大數(shù)據(jù)集群。它并非簡單地將開源組件搬運上云,而是深度融合了華為云的基礎設施優(yōu)勢與多年的大數(shù)據(jù)技術積淀,提供了開箱即用、彈性伸縮、運維簡化的全托管服務。用戶無需關心底層基礎設施的部署、監(jiān)控、擴容與升級,可以專注于業(yè)務邏輯與數(shù)據(jù)分析本身,極大降低了大數(shù)據(jù)平臺的技術門檻和運維成本。
其核心在于提供了一個統(tǒng)一的計算引擎和存儲框架,能夠對PB級甚至EB級別的數(shù)據(jù)進行批處理、交互式查詢、實時流處理以及機器學習等多種計算。通過MRS,企業(yè)可以快速構建數(shù)據(jù)倉庫、用戶畫像、實時推薦、日志分析、風險控制等多種大數(shù)據(jù)應用。
二、核心功能優(yōu)勢:為何選擇華為云MRS?
- 全托管與極致彈性:MRS提供完全托管服務,從集群創(chuàng)建、組件配置、監(jiān)控告警到版本升級,全部由華為云自動化完成。其彈性伸縮能力尤為突出,可根據(jù)業(yè)務負載(如CPU/內存使用率、作業(yè)隊列長度)自動增加或減少計算節(jié)點,實現(xiàn)資源的按需使用和成本優(yōu)化,從容應對業(yè)務高峰與低谷。
- 高性能與開源兼容:服務底層基于華為云高性能計算(ECS)、存儲(OBS)和網(wǎng)絡,并對開源組件進行了深度優(yōu)化,在相同資源配置下能獲得更優(yōu)的計算性能。它100%兼容開源接口,確保現(xiàn)有的Hadoop/Spark生態(tài)工具、作業(yè)和代碼可以平滑遷移上云,保護企業(yè)已有投資,實現(xiàn)無縫過渡。
- 企業(yè)級安全與可靠性:安全是企業(yè)上云的生命線。MRS提供多維度的安全保障:
- 網(wǎng)絡安全:支持VPC隔離、安全組、細粒度的IP白名單控制。
- 數(shù)據(jù)安全:支持數(shù)據(jù)傳輸與靜態(tài)加密(集成KMS)、細粒度的權限訪問控制(Ranger/Kerberos)。
- 容災與高可用:核心組件均采用高可用部署,數(shù)據(jù)支持多副本存儲,并結合華為云跨可用區(qū)(AZ)部署能力,提供金融級的數(shù)據(jù)可靠性與業(yè)務連續(xù)性保障。
- 運維智能化與成本透明:提供可視化的集群監(jiān)控大盤,關鍵指標一目了然。內置智能運維助手,可對集群健康狀態(tài)進行診斷,提供優(yōu)化建議。成本管理清晰透明,用戶可詳細查看資源消耗情況,結合彈性伸縮有效控制總體擁有成本(TCO)。
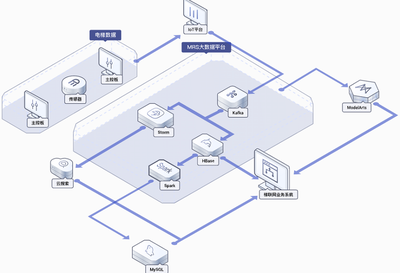
- 豐富的組件與生態(tài)集成:一站式集成Hadoop、Spark、Flink、Hive、HBase、Kafka、Presto等數(shù)十種主流大數(shù)據(jù)組件,并支持與華為云數(shù)據(jù)倉庫DWS、數(shù)據(jù)湖探索DLI、AI平臺ModelArts等服務的無縫對接,輕松構建從數(shù)據(jù)接入、處理、存儲到分析與智能化的完整數(shù)據(jù)流水線。
三、典型場景案例:上云無憂的數(shù)據(jù)處理實踐
場景一:離線數(shù)據(jù)倉庫與批量分析
某大型零售企業(yè)需要每日分析前一天的全國銷售數(shù)據(jù)、庫存情況和用戶行為,生成各類報表供管理層決策。傳統(tǒng)自建Hadoop集群資源利用率低,擴容周期長。遷移至華為云MRS后,利用其Hive/Spark組件構建云上數(shù)據(jù)倉庫。每日凌晨,通過定時作業(yè)自動從業(yè)務數(shù)據(jù)庫同步數(shù)據(jù)至MRS HDFS,執(zhí)行復雜的ETL和聚合分析任務。借助彈性伸縮功能,在數(shù)小時的作業(yè)執(zhí)行期間自動擴容計算資源,任務完成后自動縮容,分析效率提升50%,整體成本下降約30%。
場景二:實時流處理與風險監(jiān)控
一家金融機構需要實時處理每秒數(shù)萬筆的交易流水,進行反欺詐和異常交易監(jiān)測。他們使用MRS提供的全托管Flink服務,構建實時流處理管道。交易數(shù)據(jù)通過Kafka實時接入,F(xiàn)link作業(yè)進行實時規(guī)則計算、特征提取和模型推理(集成ModelArts),毫秒級內識別風險交易并告警。MRS保障了Flink作業(yè)的高可用與Exactly-Once語義,運維團隊無需深入Flink底層,即可保障7x24小時的關鍵業(yè)務穩(wěn)定運行。
場景三:交互式查詢與數(shù)據(jù)探索
互聯(lián)網(wǎng)公司的產(chǎn)品運營團隊需要即時查詢海量用戶日志,進行靈活的數(shù)據(jù)探查和問題定位。基于MRS部署的Presto或Impala服務,他們可以直接對存儲在OBS(對象存儲)或HDFS中的原始或預處理數(shù)據(jù)執(zhí)行亞秒級到秒級的交互式SQL查詢,快速獲得洞察,而無需等待漫長的ETL和報表生成流程。存儲與計算分離的架構,使得數(shù)據(jù)可被多個計算引擎共享,資源利用更高效。
###
華為云MapReduce服務通過將復雜的大數(shù)據(jù)平臺管理任務轉化為簡單的云服務,賦予了企業(yè)敏捷、經(jīng)濟、安全的數(shù)據(jù)處理能力。無論是從零開始構建大數(shù)據(jù)平臺,還是將現(xiàn)有本地Hadoop集群遷移上云,MRS都提供了平滑的路徑和強大的支撐。其“上云無憂”的核心承諾,正助力越來越多的企業(yè)擺脫基礎設施束縛,釋放數(shù)據(jù)潛能,專注于業(yè)務創(chuàng)新與價值創(chuàng)造。在數(shù)字化轉型的浪潮中,華為云MRS無疑是企業(yè)構建數(shù)據(jù)競爭力的可靠云上基石。
如若轉載,請注明出處:http://m.vmpm.cn/product/25.html
更新時間:2026-10-15 18:28:56